 ツクッタヨ

読む・集める
 IT History
アイティーヒストリー
計算機が世界を変えた節目を、出典つきの読み物として並べる年代記。出典は1件ずつ一次・二次・三次に分けて表示し、取得日まで付ける。
SCREEN history.itlibra.com の画面を切り抜いたもの 1180×830
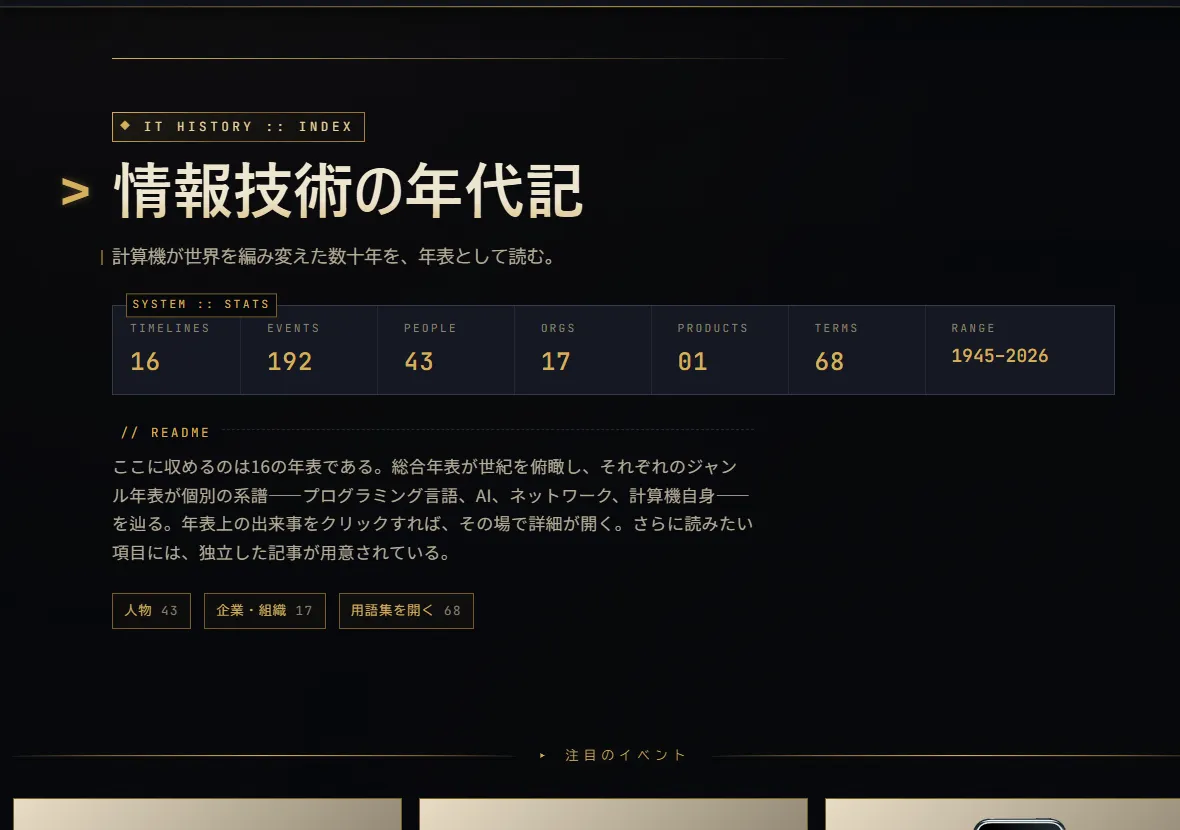
計算機が世界を変えた節目を並べた年代記です。 日本語で191ページ(出来事111・人物44・企業組織17・年表16・用語集ほか)。 英語版も同じ数だけあります。
★ 出典の扱いを、方針として先に書いています。
全ての Tier 1 記事には最低 1 件の出典が必須です。 出典は記事末尾の「Sources」セクションに、タイトル、URL、アクセス日、 1次/2次/3次資料の区別とともに明示されます。
🔴 その出典欄を、1行ずつ取り出して数えました。
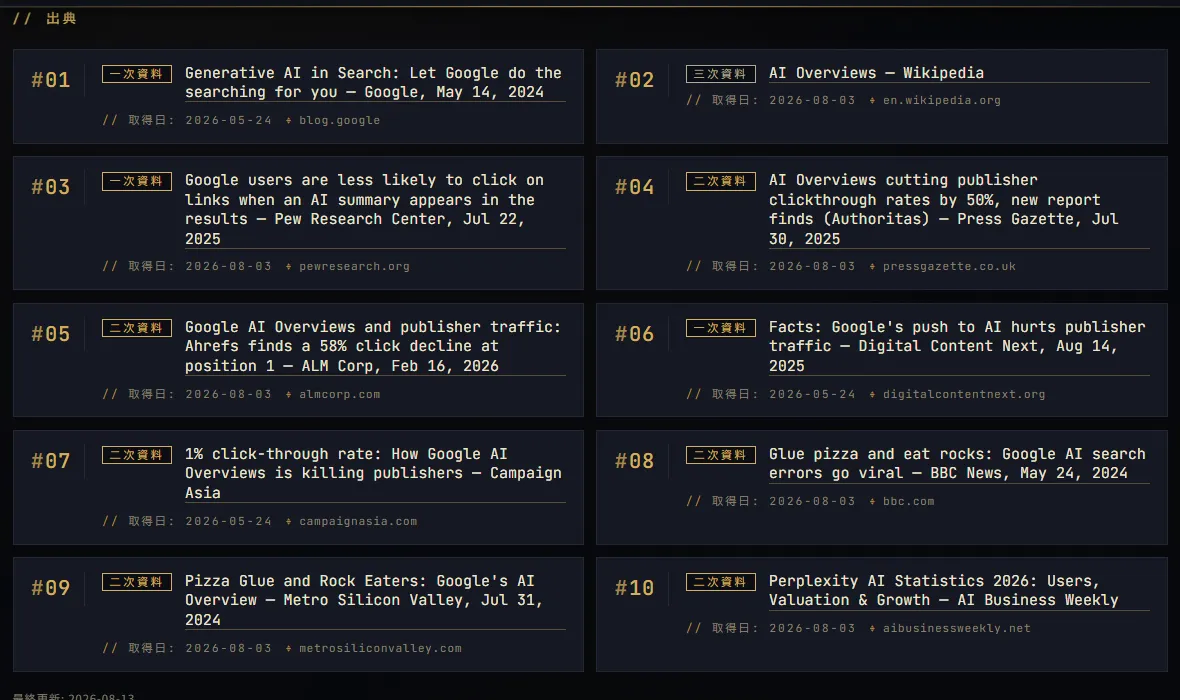
記事172本から出典の行が 1,375行。内訳は 一次769・二次387・三次219。
⭐ 確かめたことが3つあります。
★ 3つ目がいちばん効きます。 一次/二次/三次の区別は書き手が自分で付ける札なので、 ふつうは緩みます。Wikipedia を一次資料と書いた行が1つも無いというのは、 札が飾りになっていないということです。
🔴 リンクの生死も当てました。 画像のクレジットを除いた出典リンクは 1,328本。 そのうち 300本を抜き取って開いたところ、確実に切れているものは0本でした。
⭐ SEC への提出書類が78本あるのが、この年代記の特徴です。 上場・買収・決算を、報道ではなく提出書類そのもので押さえています。
SCREEN history.itlibra.com の画面を切り抜いたもの 1180×340
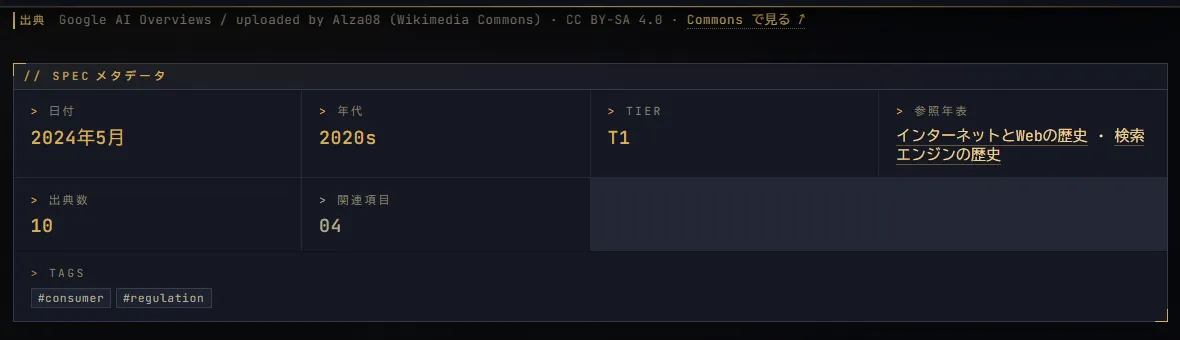
SCREEN history.itlibra.com の画面を切り抜いたもの 1180×700
出典欄を1行ずつ当てた
| 照らしたもの | 結果 | 中身 |
|---|---|---|
| 日本語ページ | 191 / 191 | sitemap の全URLが 200 で返った(英語版も191本ある) |
| 記事ページ | 172本 | 出来事111・人物44・企業組織17 |
| 出典数の表示 | 111 / 111 | ⭐ 「出典数 10」の表示と実際の行数が、全ページで一致した |
| 出典の行 | 1,375行 | 一次769・二次387・三次219 |
| Wikipedia の区分 | 216 / 216 | 🔴 Wikipedia を引いた216行が、すべて三次資料になっていた |
| 取得日 | 1,375 / 1,375 | 取得日が欠けている行は無かった |
| 出典が0本の記事 | 1 / 172 | 年表の総覧ページ1本のみ。記事はすべて出典を持っている |
| リンクの生死 | 271 / 300 | 抜き取り。確実に切れているものは0本だった |
| 証明書が合わない | 1本 | ⚠️ catb.org。https で開くとブラウザが警告を出す |
| 強調の印の漏れ | 0 / 191 | 画面にそのまま出ているページは無かった |
🔴 2026-09-07。記事の末尾にある出典欄を、番号・区分・題名・取得日・ホストの 5つに分けて取り出した。⚠️ リンクの生死は300本を抜き取って当てた(1,328本を全部叩くのは相手に負担が大きい)。
出典の出どころ(重複なし・上位)
| ホスト | 本数 | 中身 |
|---|---|---|
| en.wikipedia.org | 216 | ⚠️ すべて三次資料として扱われている |
| sec.gov | 78 | ⭐ 上場・買収・決算の一次資料 |
| apple.com | 42 | 製品発表のプレスリリース |
| cnbc.com | 40 | 二次資料(報道) |
| techcrunch.com | 32 | 同上 |
| web.archive.org | 30 | ★ 消えたページを保存版で押さえている |
| computerhistory.org | 25 | 計算機歴史博物館 |
| openai.com / anthropic.com | 33 | 20+13。近年の出来事の一次資料 |
★ 画像のクレジット(Wikimedia Commons)を除いた1,328本の内訳。⭐ SEC への提出書類が78本あるのが特徴的で、企業の節目を報道ではなく提出書類そのもので押さえている。
向いている人
向いていない人
catb.org(The Cathedral and the Bazaar)は 証明書がホスト名と合っておらず、https で開くと保護されない旨の警告が出ます。★ 相手側の問題ですが、読者の目にはこのサイトのリンクとして映ります。⭐ 区分の札が、飾りではありませんでした。
一次/二次/三次の区別は、書き手が自分で付けるものです。 だから「付けてある」だけでは何の保証にもなりません。 🔴 そこで Wikipedia を引いている行だけを抜き出して、区分を数えました。
216行すべてが三次資料。 一次や二次と書かれた行は1つもありませんでした。
★ 逆の向きも見ました。Pew Research Center を一次資料、 Digital Content Next(業界団体の自社集計)を一次資料、 BBC News や Press Gazette を二次資料——いずれも筋が通っています。
⚠️ こちらは3回、読み違えました。全部こちらの落ち度です。
🔴 直したあとの数字は 111/111 一致・食い違い0です。 ★ 最初の数字を信じていたら、無い欠陥を2つ書いていました。
⚠️ 抜き取りで確かめたことの限界。 リンクは1,328本のうち300本しか開いていません。 ★ 残り1,028本は確かめていません。 ⭐ 抜き取った300本のうち、確実に切れていたものは0本でした (403や証明書の警告は出ましたが、いずれも相手の拒否かこちらの都合でした)。
いつ、何を見て書いたかを残しています。 確認していないことは書きません。
⚠️ 本文の記述が出典どおりかは確かめていない。サイトは本文の多くを大規模言語モデルの支援で書いていると開示しており、事実は一次・二次資料で確認していると運用を書いているが、その突き合わせまではこちらでやっていない。
191ページの本文を機械で読み、強調の印(アスタリスク2つ)が画面にそのまま出ているページが無いことを確認した。0本だった。
⚠️ catb.org(The Cathedral and the Bazaar)は https で開くと証明書がホスト名と合わずブラウザが警告を出した(http なら開く)。 www の有無どちらでも同じだった。
⚠️ 引っかかった29本のうち14本は SEC で、内容は「Request Rate Threshold Exceeded」だった。こちらが叩きすぎて速度制限に当たったもので、相手の落ち度ではない。残りも Cloudflare の拒否・課金壁・こちらの TLS の問題で、確実に切れているものは0本だった。
出典リンクを集めた(画像クレジットを除いて1,328本)。そのうち300本を無作為に抜き取って開いた。271本が 200 で返り、29本が引っかかった。
取得日が欠けている出典の行が無いことを確認した(1,375行すべてに入っている)。出典が0本の記事は、年表の総覧ページ1本だけだった。
🔴 Wikipedia を引いている行だけを抜き出して区分を数えた。 216行すべてが三次資料で、一次や二次と書かれた行は無かった。
⚠️ 最初は「111ページが食い違う」と出た。原因は、行の区切りを消費して 1行おきに飛んでいたこちらの式だった。次に「7ページが食い違う」と出たが、これも題名と取得日のあいだに入る行を見落としていたためだった。
🔴 記事上部の「出典数 N」の表示と、末尾の実際の行数を突き合わせた。表示のある111ページすべてで一致した(食い違い0件)。
🔴 記事172本(出来事111・人物44・企業組織17)の出典欄を、番号・区分・題名・取得日・ホストに分けて取り出した。合計1,375行。
sitemap を取った。384URL(日本語191・英語191・トップ2)。日本語191ページを全部開き、全部 200 で返った。
 AIZEN NEWS
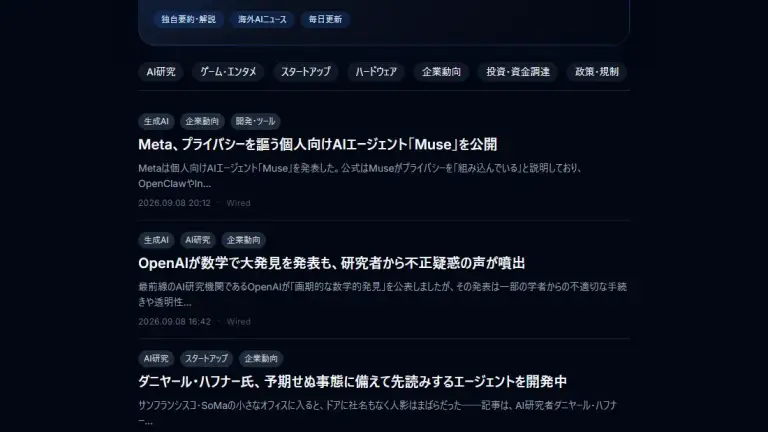
Wired・TechCrunch・MIT Technology Review などの海外AI記事を、日本語の要点整理にして並べたニュースサイト。記事は1,161本。
