ツクッタヨ

開発をたすける
 Orivel
オリベル
主要なAIモデルを、ジャンル別のお題と評価で横断比較するベンチマークサイト。ランキング・料金比較・公平性方針を持ち、英語・日本語・スペイン語で読める。
SCREEN orivel.net の画面を切り抜いたもの 980×880
主要なAIモデルを、ジャンル別のお題と評価で横断比較するサイトです。 ページは195本(英語65・日本語65・スペイン語65)あります。
Orivelは、主要AIモデルを複数ジャンル・多言語で比較するAIベンチマークサイトです。
★ トップに数が4つ並びます。
686+ ベンチマーク / 17 AIモデル / 17 ジャンル / 3 対応言語
🔴 数えました。
⭐ モデルの個別ページは17、ジャンルの個別ページも17、 言語は英語・日本語・スペイン語の3。 ★ さらに 3言語とも65ページで、経路がひとつ残らず一致していました。
⚠️ 「686+ ベンチマーク」だけは、外から数える手立てがありませんでした。
🔴 ランキングの並び方を見ました。
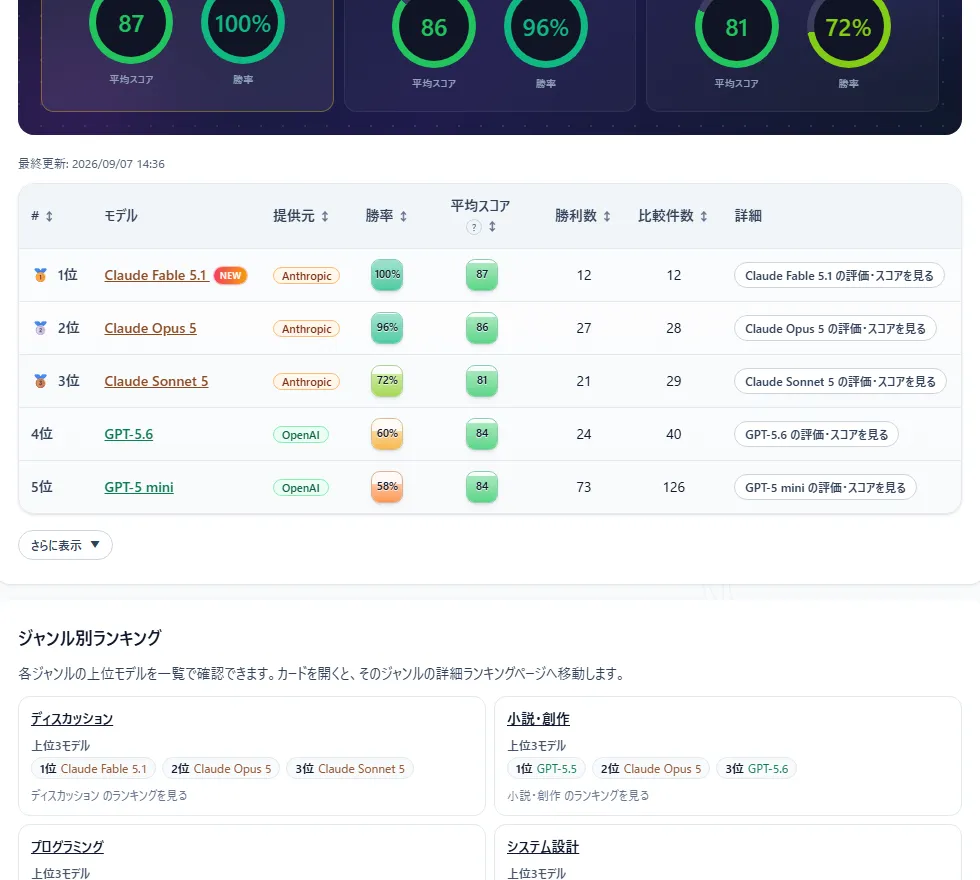
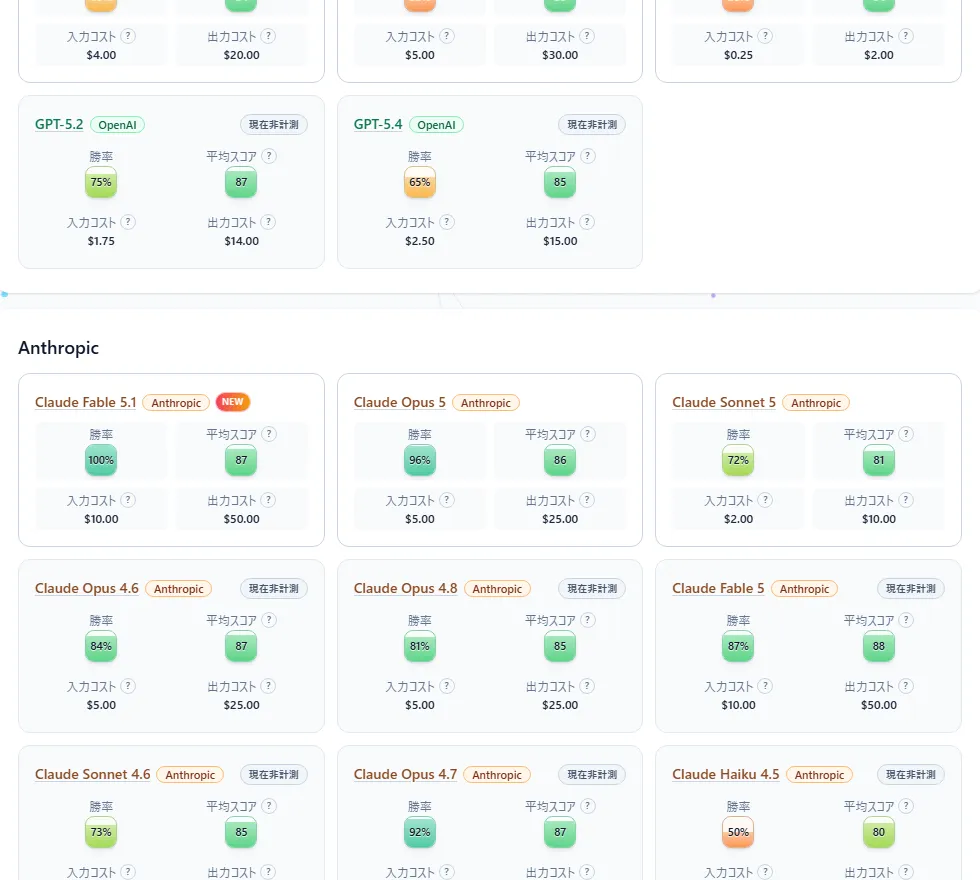
「AI性能ランキング」には、勝率と平均スコアが並びます。
1位 Claude Fable 5.1 勝率100% 平均スコア87 2位 Claude Opus 5 勝率96% 平均スコア86 3位 Claude Sonnet 5 勝率72% 平均スコア81 4位 GPT-5.6 勝率60% 平均スコア84
⭐ 勝率は 100→96→72→60→58→55→8→4→2 ときれいに降順です。 ⚠️ ところが平均スコアは 87→86→81→84→84→84 で、 🔴 3位より4〜6位のほうが高くなっています。
SCREEN orivel.net の画面を切り抜いたもの 980×880
SCREEN orivel.net の画面を切り抜いたもの 980×880
実際に当てた
| 照らしたもの | 結果 | 中身 |
|---|---|---|
| ページ | 195 / 195 | 英65・日65・西65 |
| 「17 AIモデル」 | 17 | ⭐ モデル個別ページの数と一致 |
| 「17 ジャンル」 | 17 | ⭐ ジャンル個別ページの数と一致 |
| 「3 対応言語」 | 3 | ⭐ 英語・日本語・スペイン語 |
| 言語ごとの経路 | 65 / 65 | ⭐ 3言語で完全一致。片側だけのページは無い |
| 勝率の並び | 降順 | ⭐ 100→96→72→60→58→55→8→4→2 |
| 平均スコアの並び | 降順でない | ⚠️ 3位81 < 4〜6位84 |
| 並べ替えの基準 | 書いていない | ⚠️ 見出しは「性能ランキング」 |
| 平均スコアの説明 | あり | ⭐ 各行の「?」で意味が出る |
| 公平性方針 | あり | ⭐ 採点基準を別ページで出している |
| 外部リンク | 24件 | Anthropic 6・OpenAI 8・Google 2 ほか |
| 出典らしき記載 | 45 / 195 | ⚠️ 2割強 |
| 日付の表示 | 65 / 195 | ⚠️ 3分の1。ランキングには最終更新がある |
| 強調の印の漏れ | 13 / 195 | ⚠️ モデルの個別ページに出ている |
| 「686+ ベンチマーク」 | 未確認 | ⚠️ 数えられなかった |
🔴 2026-09-08。195ページを全部開き、言語ごとに経路を突き合わせ、トップの申告(17・17・3)を sitemap で数えた。⚠️ ベンチマークの採点そのもの(どのモデルが何点か)は当てていない。
向いている人
向いていない人
⭐ 数を出しているサイトは、数を数えれば確かめられます。
トップに「686+ ベンチマーク/17 AIモデル/17 ジャンル/3 対応言語」と出ます。 🔴 sitemap から数えました。
モデルの個別ページ 17 ✓ ジャンルの個別ページ 17 ✓ 言語 3(英語65・日本語65・スペイン語65)✓
⭐ さらに3言語の経路が完全に一致していました。日本語にあって英語に無いページ、 その逆も0です。 ⚠️ 「686+ ベンチマーク」だけは、外から数える手立てがありませんでした。
🔴 ランキングの並び方に、書かれていないところがあります。
見出しは「AI性能ランキング」で、各行に勝率と平均スコアが出ます。
勝率 100 → 96 → 72 → 60 → 58 → 55 → 8 → 4 → 2(降順) 平均スコア 87 → 86 → 81 → 84 → 84 → 84 → 77 → 73 → 70(降順でない)
★ 勝率で並べていると読めますが、そうとは書かれていません。 ⚠️ 平均スコアを見て順位を理解しようとすると、 🔴 3位(81点)より4位(84点)のほうが高いので混乱します。
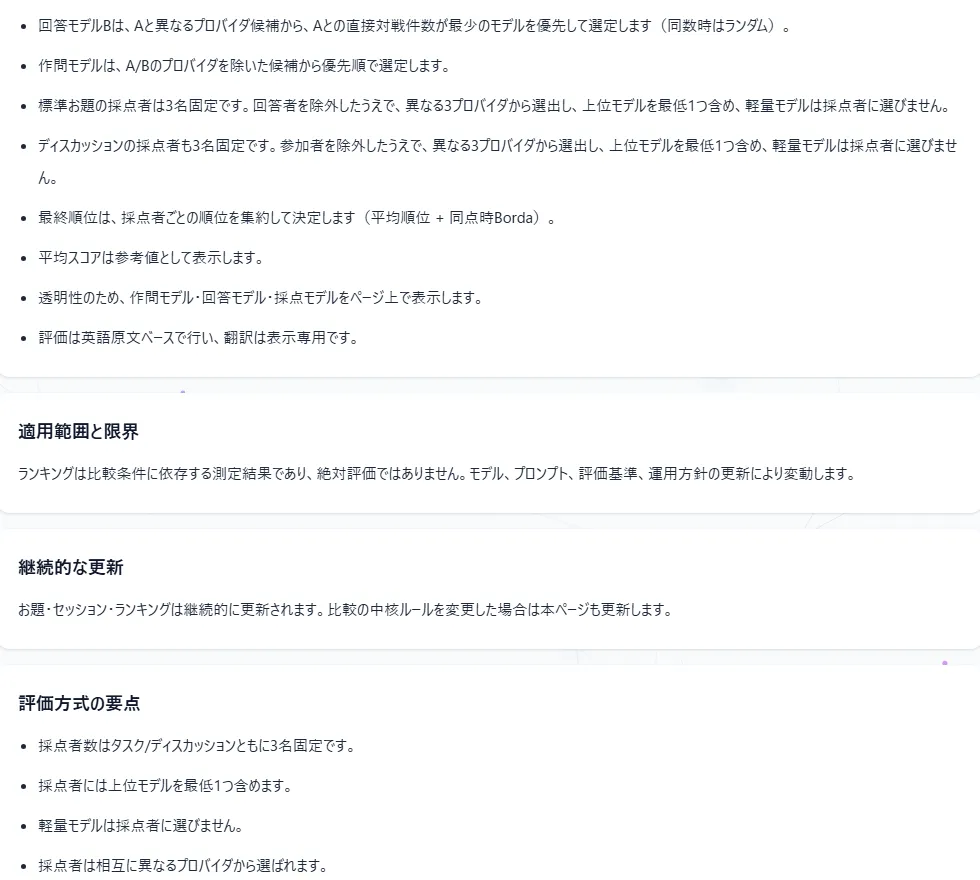
⭐ 数字の意味そのものは説明されています。 各行の「?」を押すと、 「お題回答とディスカッションの評価結果をもとに集計した総合的な平均点」と出ます。 ★ 「公平性方針」「採点基準」への導線もランキングの上にあります。 ⚠️ 足りないのは「この表は何で並んでいるか」の一行です。
⚠️ こちらが当てていないことを書いておきます。
確かめたのは数と言語の揃い方と並び順です。 ★ 「Claude Fable 5.1 が勝率100%」といった採点結果そのものは、 このサイトが自分で走らせた評価であって、 ⚠️ 外部の標準ベンチマークでも、第三者が再現できる形でもありません。 ⭐ サイトも「Orivel の比較結果で安定して高く評価されていることを示します」と、 自分の結果であることを断っています。
⚠️ 強調の印が13ページで画面に出ています。 出ているのはモデルの個別ページ(Claude Opus 5・GPT-5.5 など)で、 ★ 英語版・日本語版の両方にまたがっています。
いつ、何を見て書いたかを残しています。 確認していないことは書きません。
⚠️ 採点結果そのもの(どのモデルが何点か)は当てていない。これはこのサイトが自分で走らせた評価で、外部の標準ベンチマークではなく、第三者が再現できる形にもなっていない。
⚠️ 195ページ中、出典らしき記載は45ページ、日付は65ページ。強調の印(アスタリスク2つ)が画面にそのまま出ているページが13本あり、モデルの個別ページ(英語版・日本語版の両方)に出ている。
外部リンクは実数24件で、Anthropic 6・OpenAI 8(openai.com 5+developers 3)・ Google 2・platform.claude.com 2 など、モデル提供元の公式ページが中心だった。
平均スコアの意味は各行の「?」で説明が出る(お題回答とディスカッションの評価結果を集計した総合的な平均点)。公平性方針と採点基準のページもある。
🔴 総合ランキングの並びを見た。勝率は 100・96・72・60・58・55・8・4・2 と降順だが、同じ並びの平均スコアは 87・86・81・84・84・84・77・73・70 で降順ではない。 3位(81)より4〜6位(84)のほうが高い。何順かは書かれていない。
⚠️ 「686+ ベンチマーク」は、外から数える手立てが無く確かめていない。
🔴 トップの申告を数えた。モデルの個別ページ17・ジャンルの個別ページ17・言語3で、いずれも申告どおり。3言語の経路は完全に一致し、片側だけのページは0だった。
sitemap の 195 URL を全部開いた。英語65・日本語65・スペイン語65。全URLが 200 で返った。